1 Concepts généraux en statistique inférentielle
Frédéric Santos 
1.1 Échantillonnage
1.1.1 Population
En statistique, on appelle population l’ensemble (généralement inconnu dans sa totalité) des individus étudiés.
Quelques exemples :
- En théorie des sondages, avant une élection présidentielle, la population dont on étudie les intentions de vote pourra par exemple être l’ensemble des Français inscrits sur les listes électorales.
- En anthropologie biologique, si l’on s’intéresse à la morphologie crânienne des Néandertaliens, la population pourra tout simplement être l’ensemble des Néandertaliens ayant existé (ensemble éventuellement restreint à une certaine période chronologique ou une certaine aire géographique plus délimitées).
Bien entendu, dans les deux cas, la population totale est inaccessible dans sa totalité : l’institut de sondage ne pourra pas interroger 30 millions de personnes avant l’élection, pas plus que l’archéo-anthropologue ne pourra posséder tous les restes osseux de tous les Néandertaliens ayant existé.
1.1.2 Échantillon
L’échantillon est l’ensemble des individus réellement accessible à l’expérimentateur : c’est sur lui que se base concrètement l’étude.
Pour reprendre les exemples précédents :
- Un institut de sondage pourra par exemple contacter par téléphone un échantillon de 1000 personnes, supposément représentatif (de par sa composition) du corps éléctoral français.
- Un anthropologue pourra disposer d’un échantillon d’une douzaine de crânes néandertaliens, issus de diverses collections, pour y effectuer les mesures nécessaires à son étude.
1.1.3 But de la statistique inférentielle
Dans les deux cas, le but de l’étude est d’essayer de deviner un paramètre inconnu de la population totale (la proportion de votants pour un candidat donné, ou le volume crânien néandertalien par exemple) à l’aide de l’information fournie par un échantillon plus réduit.
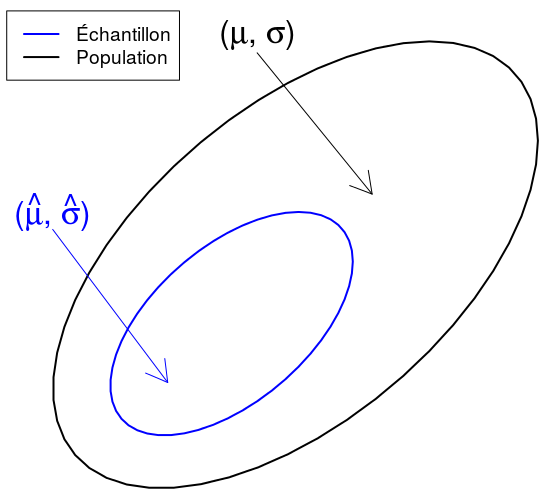
C’est le but de la statistique inférentielle (du latin inferre, déduire) : remonter vers la population totale à partir des observations effectuées sur un nombre limité d’individus, tout en quantifiant l’incertitude intrinsèquement liée à ce processus.
1.1.4 Fluctuations d’échantillonnage
Même dans le cas des sondages (par nature plus maîtrisable que le cas des sciences archéologiques), la composition d’un échantillon n’est jamais parfaitement représentative de la population dans son ensemble : il en offre une image plus ou moins déformée.
En d’autres termes : chaque échantillon issu de la population, puisqu’il est choisi (ou obtenu) aléatoirement, fournira une information légèrement différente quant au paramètre à estimer.
En effet : imaginons qu’un institut de sondage interroge 1000 personnes sur leurs intentions de vote. Par exemple, 250 d’entre elles déclareront voter pour un certain candidat. Mais un autre institut de sondage, en interrogeant lui aussi 1000 personnes, obtiendra peut-être seulement une proportion de 220 votants sur 1000, alors qu’un troisième institut de sondage obtiendra quant à lui 270 votants sur 1000. Dans ce contexte, que choisir ?
- Préférer le premier institut de sondage, et dire comme lui que le candidat obtiendra sans doute 25% des voix à l’élection ?
- Faire une synthèse des trois instituts, et déclarer que le candidat obtiendra “n’importe quoi entre 22 et 27% des voix” ?
- Imaginer même que la fourchette pourrait être plus large que ça (qui nous dit qu’un quatrième institut de sondage ne pourrait pas obtenir un échantillon avec seulement 200 votants sur 1000 ?), et donner une conclusion encore plus prudente et floue ?
Il y a donc une incertitude liée par nature à la notion d’échantillonnage, et tout l’objet de la statistique est de tenter de la maîtriser pour pouvoir tirer les conclusions les plus fiables possibles malgré tout.
1.2 Estimation ponctuelle
Lorsque l’on tente d’estimer un paramètre inconnu de la population totale par une valeur unique calculée sur un échantillon, on parle d’estimation ponctuelle.
- Sur la Figure 1.1, cela correspond au fait d’estimer le paramètre \(\mu\) de la population par la valeur \(\hat{\mu}\) calculée sur l’échantillon.
- Dans le cas de la théorie des sondage, cela correspond au fait de déclarer que “le candidat obtiendra 25% des voix”, si on a observé que 250 personnes sur 1000 interrogées avaient l’intention de voter pour lui.
1.3 Estimation par intervalle de confiance
Cependant, l’estimation ponctuelle ne rend pas compte de l’incertitude liée aux fluctuations d’échantillonnage. Il est souvent très utile (et plus réaliste !) de donner également une fourchette de valeurs probables pour le paramètre \(\mu\) à estimer, plutôt qu’une valeur unique.
Cette fourchette se calcule mathématiquement à partir des données de l’échantillon, et possède une certaine probabilité de recouvrement, c’est-à-dire, une certaine probabilité de contenir la “vraie valeur” du paramètre à estimer.
Plus précisément :
- On possède un échantillon de \(n\) valeurs, que l’on peut noter \((x_1, \ldots, x_n)\), issues de la population. De plus, on note \(\mu\) le paramètre de la population totale que l’on souhaite estimer.
- On note \(B_1\) et \(B_2\) les bornes inférieure et supérieure de la “fourchette de valeurs crédibles” \([B_1, B_2]\) que l’on souhaite construire pour \(\mu\). Ces bornes se calculent à partir des données de l’échantillon, i.e., il existe deux fonctions (deux “formules”) \(f_1\) et \(f_2\) telles que \(B_1 = f_1(x_1, \ldots, x_n)\), et \(B_2 = f_2(x_1, \ldots, x_n)\).
- On appelle probabilité de recouvrement de \(\mu\) par l’intervalle \([B_1, B_2]\) la probabilité \(\mathbb{P} \{ \mu \in [B_1, B_2] \}\).
- Alors, on appelle intervalle de confiance de niveau 95% tout intervalle dont la probabilité de recouvrement du \(\mu\) est égale à 95%.
En utilisant uniquement votre intuition, comment pensez-vous que la largeur d’un intervalle confiance varie en fonction de :
- la taille de l’échantillon ?
- la variabilité des données ?
Ces résultats peuvent (plutôt aisément) se prouver mathématiquement.
1.4 Un exemple concret avec R
Accéder au premier document computationnel via Binder :

01_simulations_intervalles_de_confiance.ipynb.1.5 Résumé de la démarche statistique
Une étude statistique s’effectue donc généralement en trois étapes :
- Choisir et collecter un échantillon d’individus si possible suffisamment représentatif de la population globale. En règle générale, c’est l’objet de la théorie des sondages, mais c’est beaucoup plus compliqué en archéologie.
- Décrire cet échantillon de façon à résumer ses grandes caractéristiques : c’est l’objet de la statistique descriptive, ou exploratoire.
- Extrapoler afin de déduire les caractéristiques de la population globale (inconnue) : c’est l’objet de la statistique inférentielle.